책의 첫머리를 펼쳤을 때 속표지와 함께 가장 먼저 보이는 곳은 판권면이다. 이곳은 도서명과 저자와 같은 기본적인 정보에서부터, 무단 전재 및 복제 금지 문구까지 적혀있는 공간이다. 책을 읽을 때 종종 이 판권면을 확인하는 경우가 있는데, 이번에 눈에 띄는 문장이 있었다.
▶ 인공지능(AI) 기술 또는 시스템을 훈련하기 위해 이 책의 전체 내용은 물론 일부 문장도 사용하는 것을 금지합니다.
문장을 읽고 나니 최근 사건이 떠올랐다. 인공지능(Artificial Intelligence, 이하 AI) 기업들이 학습 데이터를 확보하기 위해 책을 다량으로 구매하여 스캔하고, 원본 종이책은 파기하는 것. 심지어 해당 책이 절판되어 더 이상 구매할 수 없는 헌책이더라도 예외는 없다. 지난달에는 우리나라의 서점에도 요청과 주문이 들어와 기사화되기도 했다.
AI는 데이터의 영향을 크게 받는다. 특히나 ChatGPT와 같은 대규모 언어 모델(Large Language Model, 이하 LLM)은 방대한 텍스트 데이터를 바탕으로 학습한다. 생성형 AI가 출시되며 보편적으로 사용되기 시작한 지 약 3년이 지났다. 인터넷상에서 학습할 수 있는 텍스트 중에서도 AI가 생성한 텍스트가 3년간 쌓여온 것이다. 이때 인간이 직접 쓴, 혹은 AI가 집필에 도움을 줬더라도 최소한 인간의 교열과 편집을 거친 ‘책’은 AI가 먹을 수 있는 고품질 데이터로 기능한다. 이렇기 때문에 수많은 기업이 도서 구매를 원했던 것이다.
그러면 AI는 어떤 과정을 거쳐 결과물을 내놓는 것일까? 이미 널리 알려져 있듯, LLM은 학습 데이터에서 나타난 패턴을 바탕으로 가장 확률이 높은 단어를 생성한다. 그런데 막상 AI에 대해 생각하다 보니 기본적인 상식을 제외하고는 정확히 알고 있는 정보가 없었다. 어떻게 데이터를 학습하고 결과를 예측하는지, 어떻게 사람의 언어를 이해하고 콘텐츠를 생성해 내는지 그 원리에 대한 것들 말이다.
큐피드 찬의 『산책하듯 읽는 AI』는 AI에 대한 기본적인 개념을 아이가 이해할 수 있을 정도로 쉽게 설명해 주는 것부터 시작해, AI를 움직이는 핵심 원리와 기술에 대해 어려운 방정식이나 코딩 없이 유쾌한 비유로 이해를 돕는다. 필요하다면 그림과 그래프를 사용하기도 한다.
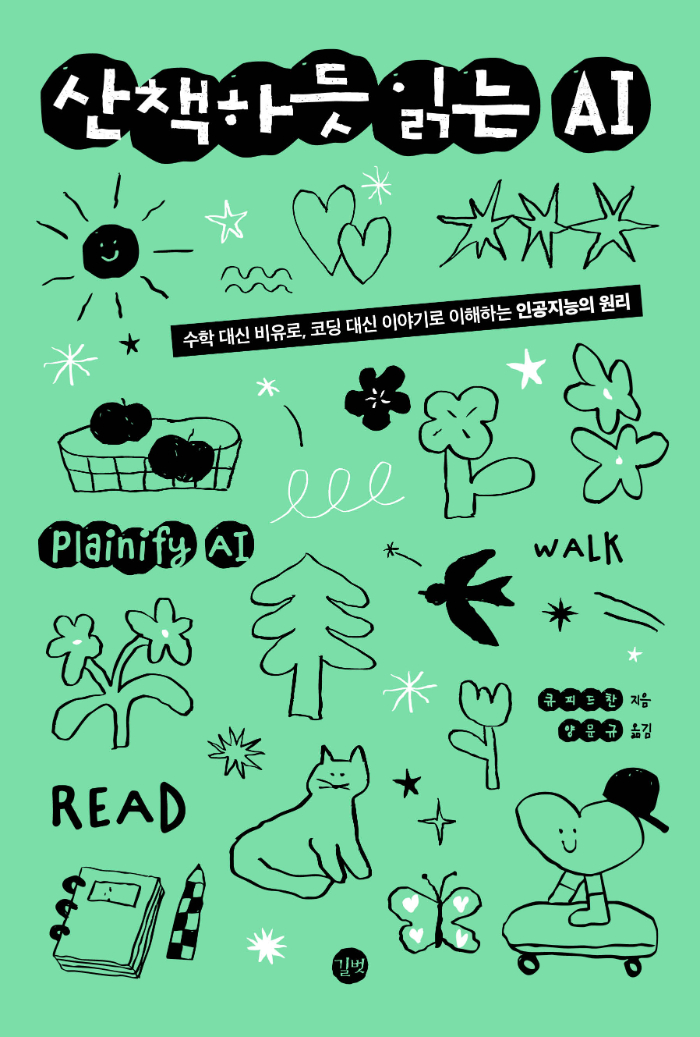
1장부터 2장까지, AI의 기본적 개념을 설명하는 챕터에서는 저자 큐피드 찬이 자녀와 대화하는 방식으로 진행된다. 어렸을 적 과학 학습만화를 보는 듯한 느낌으로 집중하다 보면, 어느새 복잡한 알고리즘 모델과 딥러닝 신경망까지 다루고 있다. 3장부터는 대화 형식이 아니며 점점 어려운 분야로 들어가나, 여전히 직관적인 서술 방식을 활용하는 데다 일상적인 비유를 들고 있어 충분히 이해할 수 있다.
여기에 역자의 센스까지 보태졌다. 이해가 어려울 수 있는 부분에 ‘역자의 노트’를 통해 부가 설명과 새로운 이야기를 더했다. 이렇게 반복적으로 등장하는 개념들은 일부러 머릿속에 집어넣지 않아도 서서히 익숙해진다.
AI 윤리 문제 역시 기술에 대해 알아야 더 생산적으로 논의할 수 있다. 『산책하듯 읽는 AI』에서는 이를 ‘AI와 연애 중’이라 표현하며 서술한다. 편향 문제는 첫인상으로, 개인 프라이버시 문제는 ‘지나치게 간섭하는 연인’으로 재미있게 비유하는 것은 물론, 기술적인 면에서의 설명이나 해결해 나가기 위한 방법을 제시하는 등 겉핥기식으로만 이야기하는 것이 아니라 독자가 AI 윤리 문제에 대해 더 고민해 볼 수 있도록 돕는다.
산책하듯 읽는 AI
길벗. 큐피드 찬 지음, 양문규 옮김